1.5.2 데이터를 구조화해야 하는 이유 정리
학습목표
본 장에서는 수많은 데이터 종류를 체계적으로 분류하고 구조화해야 하는 근본적인 이유를 파악합니다. 데이터의 성격(수치형 vs 범주형 등)에 따라 적용해야 할 그래프(시각화) 방식과 결측치(빈 값) 처리 로직이 완전히 달라짐을 이해하여, 데이터 분석의 올바른 첫 단추를 꿰는 역량을 기릅니다.
데이터의 종류
왜 이렇게 귀찮게 데이터의 종류를 다 외우고 구분해야 할까요?
왜냐하면 우리가 파이썬을 이용해 어떤 막대그래프를 그릴지, 아니면 꺾은선 그래프 모양을 그릴지는 전적으로 데이터의 종류에 따라 결정되기 때문입니다.
데이터 종류와 결측치(빈값)의 처리
실제 세상의 빅데이터는 완벽하지 않습니다.
나이를 안 적은 사람, 성별을 응답하지 않은 사람처럼 데이터에 빵꾸(결측치)가 뚫려 있습니다.
결측치란? 데이터에 값이 비어있는 상태를 말합니다.
나이가 빵꾸났다면 ‘전체 평균 나이’로 채워 넣으면 되지만, 성별에 빵꾸가 났다고 ‘평균 성별 1.5’를 채울 순 없습니다.
가장 많이 등장한 성별(최빈값)로 채워야만 합니다.
최빈값이란? 데이터에서 가장 빈번하게 나타나는 값을 말합니다.
데이터의 성격을 정확히 알아야만 이런 적절한 조치를 취할 수 있습니다.
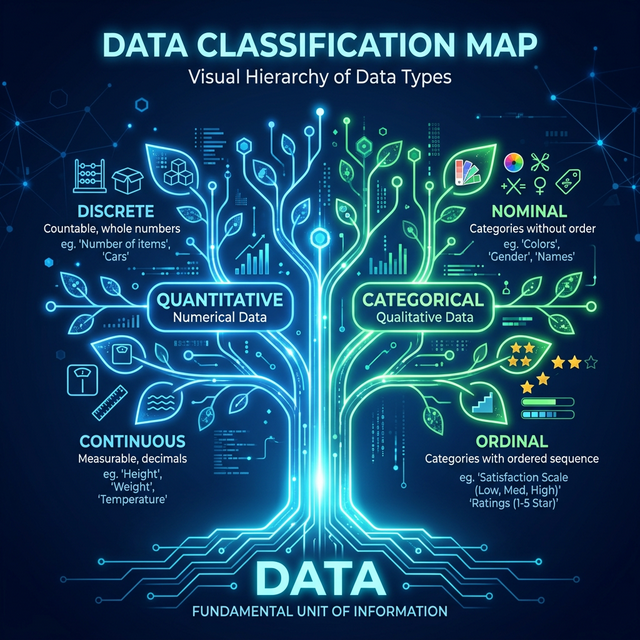
정리
데이터를 세분화하고 구조화하는 작업은 단순한 암기가 아니라, 컴퓨터에게 올바른 명령을 내리기 위한 분석가의 필수적인 상황 판단 작업입니다.
- 시각화의 관건: 분석하려는 데이터가 수치형(연속)이면 꺾은선/산점도 그래프를, 범주형(불연속)이면 막대그래프를 그려야 의미 있는 통찰을 얻을 수 있습니다.
- 결측치(빈 값) 처리의 생명: 구멍 난 데이터를 메울 때, 연속형 숫자 데이터라면 ‘평균값’을 사용해도 무방하지만 명목형/서열형 데이터라면 가장 많이 등장하는 ‘최빈값(Mode)’을 사용해야 데이터 모델의 붕괴를 막을 수 있습니다.
결국 데이터의 근본적인 ‘종류’를 정확하게 감별해 내는 시력을 갖추어야만, 수집 단계 이후의 올바른 전처리와 최적의 머신러닝 알고리즘을 선택할 수 있습니다.
서브목차